Circula uma publicação que garante que um estudo recente «provou» que Chomsky estava errado e que falamos como o ChatGPT. Em vez de discutir a publicação, fomos ler o artigo de ponta a ponta. É um trabalho cuidadoso, com seis estudos e resultados pequenos mas consistentes, e que diz coisas interessantes para quem ensina línguas. Diz também bastante menos do que lhe atribuem.

A publicação resume-se depressa: o cérebro não guarda a linguagem em árvores gramaticais, falamos a prever o bloco seguinte e é assim que funciona o ChatGPT. Do artigo, o que há a registar é outra coisa, e merece ser contada com algum vagar.
A pergunta de partida
O artigo de Yngwie A. Nielsen e Morten H. Christiansen saiu na Nature Human Behaviour a 21 de janeiro de 2026 (volume 10, páginas 579 a 588), depois de aceite em dezembro de 2025. Christiansen é professor de Psicologia em Cornell e Nielsen trabalha na Universidade de Aarhus, na Dinamarca. Os dois partem de uma pergunta antiga: como é que qualquer falante consegue produzir e compreender frases que nunca ouviu?
Os autores descrevem duas respostas clássicas. Na primeira, a mente tem um léxico e uma gramática generativa, e esta combina palavras em constituintes, que são grupos de palavras encaixados uns nos outros. Em «o rapaz deu o livro à rapariga», «o livro» é um constituinte, «deu o livro à rapariga» é outro, e assim sucessivamente até à frase inteira. Na segunda, mais próxima das abordagens construcionistas, a mente guarda construções, isto é, formas com um sentido convencionado, que vão de palavras soltas a expressões fixas e a padrões de frase.
Há, porém, um problema que a investigação sobre blocos de palavras (ou lexical bundles) já tinha levantado. Sequências como in the middle of the lêem-se mais depressa do que equivalentes menos frequentes, mas não são constituintes, porque deixam um grupo preposicional a meio, e também não é claro que tenham um sentido convencionado. Seriam, então, estruturas que não são nem uma coisa nem outra. É essa lacuna que o artigo quer testar.
Como se testa uma coisa destas
O instrumento é o priming estrutural. Quando processamos uma estrutura, ela deixa um rasto, e outra frase com a mesma estrutura é processada mais depressa a seguir. Durante décadas este efeito foi usado como argumento a favor da realidade psicológica dos constituintes. Nielsen e Christiansen usam-no ao contrário: aplicam-no a sequências de três palavras que não são constituintes, descritas apenas pela sua sequência de classes de palavras (por exemplo, substantivo, preposição, determinante, como em example of an).
A tarefa dada aos participantes é simples. Aparecem três palavras no ecrã e a pessoa decide, o mais depressa que puder, se aquilo pode fazer parte de uma frase em inglês (work for a) ou não (bring am top). Em algumas dessas decisões, a sequência anterior tem a mesma estrutura de classes de palavras que a seguinte, como knew that she antes de wondered if you. Noutras, a anterior tem uma estrutura sem relação, como example of an. Se a mente guarda um padrão desse tipo, a decisão deve ser mais rápida no primeiro caso.
Seis estudos, e o que cada um acrescenta
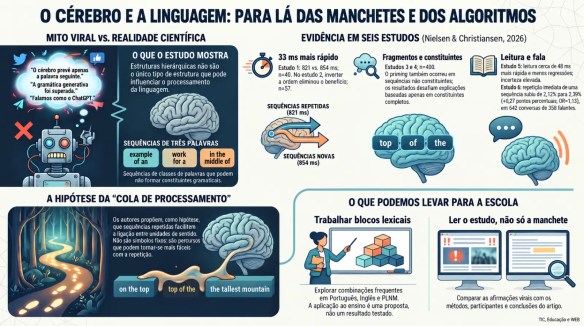
No primeiro estudo, com 40 estudantes de Cornell, a decisão foi cerca de 33 milissegundos mais rápida quando as duas sequências tinham a mesma estrutura (821 contra 854 ms, em média). O segundo estudo, com 57 estudantes da Universidade da Florida, serviu para excluir uma explicação mais simples, a de que o que se ativa são as classes de palavras soltas. Para isso inverteram a ordem (de me again and para or how you) e o benefício desapareceu, e até houve um ligeiro atraso. É a sequência que conta e não apenas o conjunto de classes.
O terceiro estudo ataca a objeção mais evidente: e se estas sequências, afinal, aparecessem muitas vezes como constituintes em frases reais? Os autores recolheram frases de um corpus de inglês americano e viram que, em média, cerca de 1% das ocorrências era de facto constituinte. Repetiram depois a experiência com 200 participantes recrutados online, metade com sequências que não são constituintes e metade com constituintes. O priming apareceu nos dois casos, com sinais moderados de que era mais forte nas sequências que não são constituintes (36 contra 20 ms, em números redondos).
O quarto estudo, também com 200 participantes, responde a uma objeção mais subtil: quem lê live in a pode estar a prever que vem aí um substantivo e a construir mentalmente o constituinte inteiro («viver num carro»). Compararam por isso fragmentos de três palavras com os constituintes de quatro em que estes se encaixam. Um fragmento ajudou mais a processar outro fragmento do que o constituinte completo, e o contrário também se verificou. Os autores consideram isto inconsistente com a ideia de que os fragmentos são sempre completados em constituintes. O total de participantes nas quatro experiências, 40 + 57 + 200 + 200, dá os 497 do resumo.
Os dois últimos estudos saem do laboratório e analisam dados já existentes. No quinto, a partir de um corpus de leitura com registo dos movimentos oculares (68 leitores de frases de jornal), uma estrutura repetida da frase anterior associou-se a uma leitura cerca de 48 ms mais rápida e a menos regressões, embora com bastante incerteza estatística e sem efeito claro na primeira passagem pelo texto. No sexto, com 642 conversas telefónicas entre 358 falantes, a probabilidade de alguém produzir uma dada sequência de classes de palavras subiu de 2,12% para 2,39% logo no turno a seguir a tê-la ouvido (uma diferença de 0,27 pontos percentuais, ou seja, cerca de 13%, o que dá um odds ratio de 1,13). São efeitos modestos, mas apareceram em dois contextos muito diferentes.
O que os autores concluem
A conclusão principal é que os constituintes não são o único tipo de estrutura que a mente usa. Os próprios autores sublinham que o resultado põe um desafio a todas as abordagens e não apenas à generativa. As construcionistas, dizem, têm mecanismos de aprendizagem suficientemente flexíveis para adquirir estas estruturas, mas quase só estudaram construções que são constituintes ou que se descrevem com constituintes, e por isso o desafio é «para todos». Notam ainda que as estruturas lineares podem ser um fator de confusão em muitos estudos anteriores de priming sintático.
Há prudências que o texto faz questão de deixar escritas. O estudo não exclui que os constituintes tenham um papel no processamento de unidades maiores do que as três palavras testadas. Os resultados limitam-se ao inglês, e, embora os autores esperem que se estendam a outras línguas, dizem que é preciso investigá-lo. E não afirmam que as sequências de classes de palavras estejam guardadas como símbolos. Tratam-nas como uma forma de descrever percursos de processamento, que ficam mais fáceis de percorrer à força de passarem por lá, como as pegadas que se vão alargando num caminho de floresta.
A hipótese mais ousada é uma proposta a testar: que estas sequências sirvam de «cola de processamento» entre unidades com sentido, ajudando a encaixá-las em tempo real. Por exemplo, top of the a ligar on the top a the tallest mountain. Está na conclusão como especulação, e assim deve ser lida.
E os modelos de linguagem?
O artigo toca nos modelos de linguagem, mas de passagem. Refere que uma rede neuronal reproduzia boa parte dos resultados de priming sintático, e que resultados convergentes foram obtidos com grandes modelos de linguagem. Os autores tiram daí que o priming pode, em princípio, assentar em estruturas que não são constituintes, e acrescentam que não se sabe que representações o modelo usa. É tudo. Não dizem que os humanos falam como o ChatGPT, e a ideia de que falamos «a prever o bloco seguinte» não é uma conclusão deles. Pelo contrário, o quarto estudo discute e afasta uma explicação baseada na previsão de estruturas maiores. Convém, por isso, não confundir duas coisas: um modelo estatístico e uma pessoa podem ambos mostrar priming, o que não os torna a mesma máquina. Já escrevemos sobre essa diferença a propósito do ensaio de Renato Ortiz, e sobre o facto de a fluência não provar compreensão.
Quanto a Chomsky, o nome não aparece no texto principal do artigo. Surge na bibliografia, com O Programa Minimalista (1995), citado a propósito das formas de descrever a estrutura em constituintes. O alvo declarado é a ideia de que a representação mental da linguagem assenta em constituintes. A manchete é de quem a escreveu.
O que isto tem a ver com a escola
Para começar, convém ver quem participou. Foram estudantes universitários, adultos recrutados online e falantes de inglês dos corpora, sem um único aluno do básico ou do secundário e sem nenhum falante de português. Tudo o que se segue é, portanto, extrapolação nossa e deve ser lido assim.
A gramática do Português trabalha constituintes e funções sintáticas ao longo dos anos: no 9.º, as Aprendizagens Essenciais pedem que o aluno analise frases simples e complexas para identificar constituintes e funções sintáticas (Direção-Geral da Educação, s.d.-a), e no secundário o conhecimento dos grupos da frase é para sistematizar (Direção-Geral da Educação, s.d.-b). O estudo não testa ensino nenhum e não dá razões para abandonar a análise sintática. Uma coisa é o que a gramática escolar permite ver numa frase, o que continua a ser útil, a ler e a escrever melhor. Outra é o que a mente faz em poucas centenas de milissegundos. A distinção é nossa, e dá boa conversa para um grupo disciplinar.
Nas aulas de língua, o que o artigo reforça, sem demonstrar para o ensino, é a importância dos blocos. O próprio texto cita como exemplo de bloco frequente in accordance with, que tem tradução óbvia em «de acordo com». Se a mente aprende e reutiliza sequências, faz sentido trabalhar expressões e combinações habituais, em Português, em Inglês e em Português Língua Não Materna, e não só vocabulário isolado. A equipa de Cornell admite que as conclusões podem vir a ter alguma coisa a dizer sobre o ensino de segundas línguas (Blackwood, 2026), mas é uma expectativa e não um resultado.
Quem corrige redações conhece também os blocos feitos que aparecem sem ninguém os pedir, como «nos dias de hoje» ou «ao longo dos tempos». É uma impressão de professor, sem dados por trás, mas liga-se ao que escrevemos sobre o texto que sai sempre com a mesma cara, seja de um aluno apressado seja de uma máquina.
Duas coisas para experimentar
As propostas são nossas, não foram testadas com alunos e o estudo foi feito em inglês.
Ler um estudo, não a manchete. Com uma turma do 9.º ano ou do secundário, e em articulação com o professor de Inglês, pôr lado a lado a publicação viral e o resumo do artigo, que está em acesso aberto na página da revista. Os alunos sublinham os verbos de certeza («prova», «completamente errado», «exatamente») e os de cautela («evidência», «desafio», «poderá»), e verificam, afirmação a afirmação, o que da publicação aparece no resumo. A seguir podem olhar para quem foram os participantes e quantos eram. A discussão ensina mais do que qualquer aviso sobre desinformação, porque aqui o estudo é verdadeiro e a publicação é que o deforma. Quem quiser enquadrar a atividade na literacia em IA tem os nossos cinco passos.
A caça aos blocos. Num texto da turma ou numa notícia, os alunos procuram, à mão ou numa folha de cálculo, sequências de três ou quatro palavras que se repetem, e perguntam-se se cada uma forma um grupo. «Ao longo do», por exemplo, junta uma locução com um determinante, e «de acordo com o» está na mesma situação. Que a mente guarde sequências assim é uma hipótese a discutir e não um resultado, e saber se acontece em português europeu é uma pergunta em aberto. Que os alunos a formulem já é bom treino.
Reservas
Não somos linguistas, e a discussão entre as escolas teóricas é técnica e vai longe. Lemos o texto principal do artigo e não o material suplementar, onde os autores discutem outras noções de constituência. Os efeitos medem-se em dezenas de milissegundos e alguns intervalos de incerteza incluem o zero, como acontece no estudo da leitura. Os autores usam análise bayesiana, que fala em graus de evidência e não em «significativo» ou «não significativo», e convém lê-la assim. Trata-se de um conjunto de estudos pré-registados e com dados abertos, o que conta a favor, mas continua a ser um conjunto de estudos, e a discussão só agora começou.
Uma pergunta para levar
Quando um aluno nos mostrar, amanhã, mais uma manchete que começa por «estudo prova», saberá ir ver quantos eram os participantes, quem eram e o que os autores escreveram na conclusão? Talvez valha a pena ensinar-lhe esse gesto antes de lhe ensinarmos a desconfiar de tudo.
Nota editorial e de transparência. Este artigo foi elaborado com assistência de inteligência artificial (Claude, da Anthropic), a partir do texto principal do artigo de Nielsen e Christiansen (2026), lido na íntegra numa cópia alojada em servidor da Universidade de Cornell, e do comunicado da Cornell Chronicle (Blackwood, 2026), consultados a 26 de outubro de 2026. Os exemplos para a sala de aula são propostas nossas. O texto foi sujeito a revisão e à responsabilidade editorial dos autores do blogue.
Referências
Blackwood, K. (2026, 21 de janeiro). Discovery challenges assumptions about the structure of language. Cornell Chronicle. Consultado a 26 de outubro de 2026, em https://news.cornell.edu/stories/2026/01/discovery-challenges-assumptions-about-structure-language
Direção-Geral da Educação. (s.d.-a). Português, 9.º ano: Leitura. Lisboa no Renascimento. Funções sintáticas (1) (Bloco n.º 24) [Materiais de apoio]. Consultado a 26 de outubro de 2026, em https://estudoautonomo.dge.mec.pt/sites/default/files/inline-files/24_Portugu%C3%AAs_9%C2%BA%20ano_Leitura%20Lisboa%20no%20Renascimento.%20Fun%C3%A7%C3%B5es%20sint%C3%A1ticas%20%281%29.pdf
Direção-Geral da Educação. (s.d.-b). Os constituintes da frase e as suas funções sintáticas: A análise sintática ajuda-me a ler e escrever melhor? (Guião de Trabalho Autónomo n.º 17, Português, 11.º ano) [Materiais de apoio]. Consultado a 26 de outubro de 2026, em https://estudoautonomo.dge.mec.pt/sites/default/files/2025-02/GTA%2017_Portugu%C3%AAs.%C2%BA%20ano_tema%204_Constituintes%20da%20frase%20e%20fun%C3%A7%C3%B5es%20sint%C3%A1ticas.pdf
Nielsen, Y. A., & Christiansen, M. H. (2026). Evidence for the representation of non-hierarchical structures in language. Nature Human Behaviour, 10, 579–588. https://doi.org/10.1038/s41562-025-02387-z
Para saber mais
Fora do blogue: o artigo original, a começar pelo resumo; os dados, materiais e código no OSF, para quem quiser ver como se fez; o comunicado da Cornell Chronicle, curto e claro; e o episódio 137 do podcast Because Language, em inglês, em que os dois autores explicam o trabalho.
No blogue: Escrever com a máquina ou escrever sem ela? O que a escola pode aprender com um ensaio de Renato Ortiz; Uma IA pode ter consciência? O que pode aprender a escola com quem responde «não sabemos»; Literacia digital em ação: como combater a desinformação na sala de aula; Literacia em IA: cinco passos para a escola; Reaprender a perguntar: estamos a caminho da geração prompt?